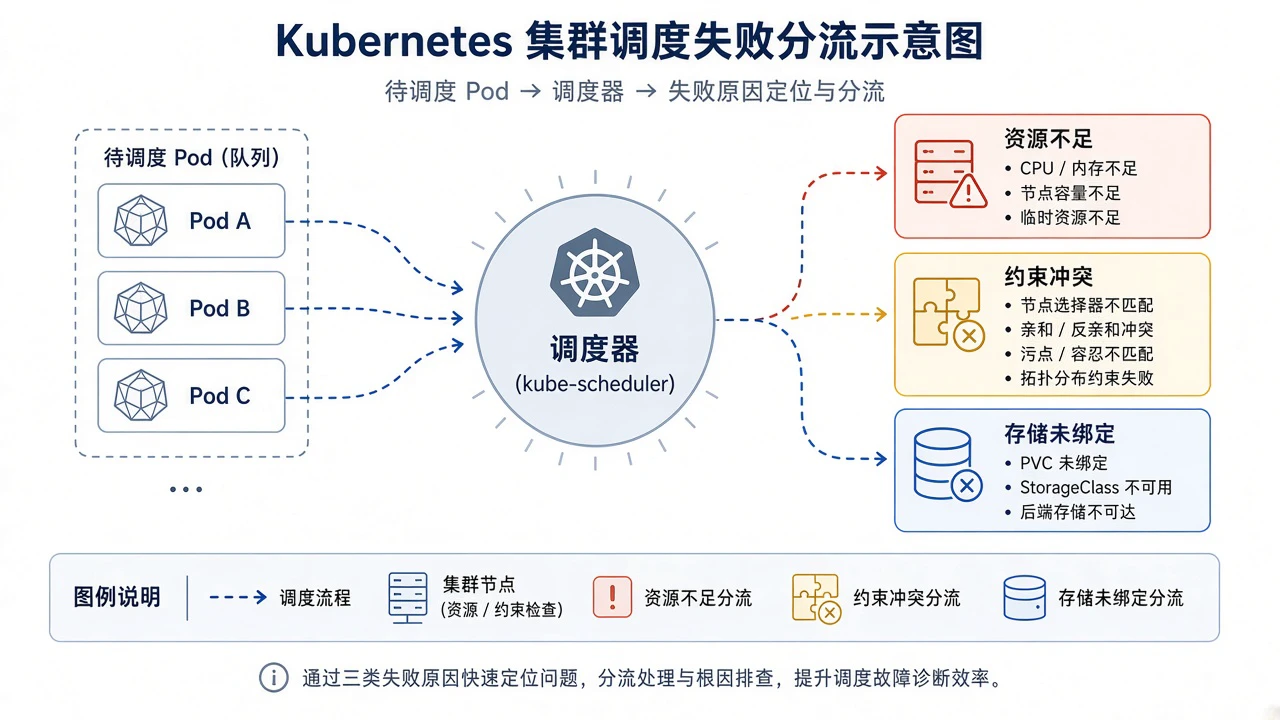
当一个或多个 Pod 长时间停留在 Pending 状态时,首先要明确这不是“Pod 坏了”,而是调度器尚未为它找到可运行的位置,或者运行前置条件没有满足。Pending 是一个等待态,背后可能是调度约束无法满足、节点可用资源不足,也可能是存储卷迟迟没有绑定。盲目删除 Pod 或直接扩容节点,往往只是掩盖现象,无法回答“为什么调度不上去”这个核心问题。本文按调度、资源、存储三个方向收敛,依靠 kubectl 查询结果和调度事件作为判断线索,为每类原因给出验证手段与安全的处理路径。
先确认影响范围与现象边界
在深入单个 Pod 之前,先判断问题是孤立的还是成片的,这决定了排查方向和处理的紧迫程度。
# 查看全集群处于非 Running 状态的 Pod,确认影响范围
kubectl get pods -A --field-selector=status.phase=Pending
如果只有个别 Pod Pending,通常指向该 Pod 自身的资源请求、亲和性或 PVC 配置;如果同一工作负载的多个副本、甚至多个命名空间的 Pod 同时 Pending,则更可能是集群级别的问题,例如节点整体资源耗尽、某个节点池不可调度,或存储后端异常。
确认范围后,锁定一个有代表性的 Pending Pod 作为分析样本。关键信息都集中在它的事件和描述里:
kubectl describe pod <pod-name> -n <namespace>重点看输出末尾的 Events 段落。调度相关的事件通常由 default-scheduler 发出,常见的提示是 FailedScheduling,后面附带的原因文字是整条排查链路最有价值的入口。不同的措辞对应完全不同的处理方向,不要只看到 Pending 就下结论。
从调度事件判断根因方向
调度器在无法放置 Pod 时,会把尝试过的节点数量和被排除的理由写进事件。学会读这段文字,就能快速把问题归到三个方向之一。
常见事件文字与其指向的方向大致对应如下:
| 事件关键文字 | 指向方向 | 说明 |
|---|---|---|
Insufficient cpu / Insufficient memory | 资源请求 | 节点可分配资源不足以满足 Pod 的 requests |
node(s) didn't match node selector / affinity | 调度约束 | nodeSelector、nodeAffinity 过滤掉了所有节点 |
node(s) had untolerated taint | 调度约束 | 节点有污点而 Pod 没有对应容忍 |
pod has unbound immediate PersistentVolumeClaims | 存储绑定 | PVC 尚未绑定到可用的 PV |
node(s) had volume node affinity conflict | 存储绑定 | 卷的拓扑约束与节点不匹配 |
0/N nodes are available 并列出多条理由 | 混合 | 不同节点因不同原因被排除,需逐条拆解 |
当事件里同时出现多条理由时,要留意数字。例如 0/6 nodes are available: 4 Insufficient memory, 2 node(s) had untolerated taint,说明六个节点里四个卡在内存、两个卡在污点,两类问题需要分别处理,解决其中一类不一定能让 Pod 调度成功。
如果 kubectl describe 里根本没有调度事件,Pod 甚至没有被调度器处理,则要检查调度器本身是否正常运行,以及是否存在准入控制或配额限制在更早的环节拦截了 Pod。
调度约束方向的核查与处理
当事件指向 node selector、affinity 或 taint 时,问题出在“Pod 对节点的要求”和“节点实际状态”之间的匹配上。
先看 Pod 实际要求了什么:
# 查看 Pod 的节点选择器、亲和性与容忍配置
kubectl get pod <pod-name> -n <namespace> -o jsonpath='{.spec.nodeSelector}{"n"}{.spec.tolerations}{"n"}'
再对照节点的标签和污点:
# 查看节点标签,确认是否存在匹配 nodeSelector 的节点
kubectl get nodes --show-labels

# 查看某节点的污点
kubectl describe node <node-name> | grep -i taint
判断逻辑是:Pod 要求的标签在节点上是否存在、要求的值是否一致、节点的污点是否有对应容忍。常见情况包括标签拼写不一致、某个节点池被人工打上了 NoSchedule 污点用于维护、或 affinity 规则过严导致只剩极少候选节点。
处理这类问题时优先修正配置源头而非临时放宽约束。如果约束本身合理,只是目标节点不满足条件,应补齐节点标签或调整节点池;如果是约束写错了,则修改工作负载的 manifest 重新应用。涉及修改 Deployment 或 StatefulSet 的调度配置时,变更前先导出当前配置做好留存:
kubectl get deployment <name> -n <namespace> -o yaml > deployment-backup.yaml回滚边界很明确:这类修改改动的是对象 spec,一旦新配置导致更多副本无法调度或调度到不期望的节点,用备份文件重新 apply 即可恢复。放宽 taint 容忍或弱化 affinity 会扩大 Pod 可落位的范围,务必确认这些约束原本不是出于隔离、合规或硬件绑定的目的,否则可能把负载调度到不该去的节点上。
资源请求方向的核查与处理
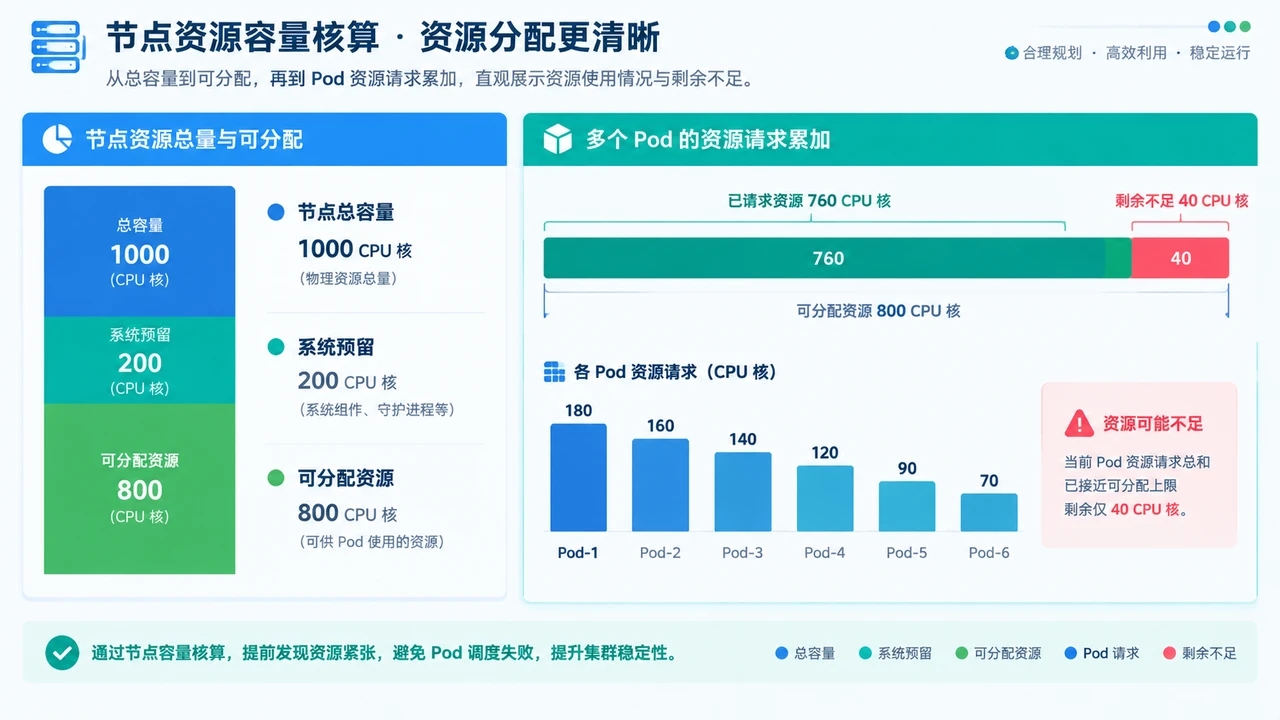
事件出现 Insufficient cpu 或 Insufficient memory 时,调度器是在用 Pod 的 requests 对比节点的可分配资源,而不是节点的空闲资源。这里有两个容易混淆的点:调度看的是 requests 不是 limits,节点的基准是 Allocatable 而非总容量。
先看目标 Pod 请求了多少:
kubectl get pod <pod-name> -n <namespace>
  -o jsonpath='{range .spec.containers[*]}{.name}{": "}{.resources.requests}{"n"}{end}'
再看节点侧的可分配量和已被请求占用的量:
# Allocatable 行给出可分配基准,Allocated resources 段给出已被 requests 占用的比例
kubectl describe node <node-name> | grep -A 15 "Allocated resources"
把 Pod 的请求和各节点的剩余可分配量逐一对照,就能判断是单个节点都放不下,还是整体容量已接近饱和。如果 Pod 本身的 requests 设置得偏高,远超实际使用,那么合理的做法是校准请求值,让它贴近真实用量;这需要参考监控里的历史资源曲线,而不是凭感觉下调。校准前同样导出配置备份,调整后观察 Pod 是否成功调度,以及调度到的节点在运行一段时间后是否出现资源压力或 OOM。
如果请求值本身合理,是集群整体容量确实不足,那么要区分这是临时尖峰还是持续趋势。扩容节点是一种手段,但不应作为默认答案:先确认是否有可以回收的闲置负载、是否存在资源碎片导致“总量够但单节点放不下”、以及是否有配额或 LimitRange 在限制。处理顺序上,先解决配置性浪费,再考虑容量调整。调整 requests/limits 属于会影响运行中负载的变更,回滚方式是恢复原配置并重新 apply,但要注意降低已运行 Pod 的 limits 可能触发重建,变更窗口和观察指标要提前规划好。
存储绑定方向的核查与处理
当事件提到 unbound ... PersistentVolumeClaims 或 volume node affinity conflict 时,问题在于 Pod 依赖的卷还没准备好,或卷的位置约束与可调度节点冲突。
先确认 PVC 的状态:
kubectl get pvc -n <namespace>PVC 处于 Pending 说明还没有绑定到 PV。接着看 PVC 的事件,判断是没有匹配的 PV、还是动态供给失败:
kubectl describe pvc <pvc-name> -n <namespace>常见原因有几类:使用的 StorageClass 不存在或拼写错误;动态供给的后端(如云盘、CSI 驱动)报错或配额耗尽;静态供给场景下没有容量和访问模式都匹配的 PV;以及 StorageClass 的 volumeBindingMode 为 WaitForFirstConsumer 时,绑定会等到 Pod 被调度才发生,此时要和调度约束一起看。
对于 volume node affinity conflict,通常是卷被限定在某个可用区或节点,而 Pod 由于其它约束无法调度到该位置,形成互相牵制。核查 PV 的节点亲和与 Pod 的调度约束是否能同时满足:
kubectl get pv <pv-name> -o jsonpath='{.spec.nodeAffinity}{"n"}'处理存储问题要格外谨慎,因为它直接关系数据。核查 StorageClass、CSI 驱动状态和后端配额属于只读操作,可以放心执行。涉及新建 PV、修改 PVC 或更换 StorageClass 时,必须确认操作不会影响已有数据的卷:PVC 一旦绑定不能随意更换 StorageClass,删除 PVC 可能触发 PV 回收,取决于回收策略,这是一条高风险、难以逆转的操作边界。更安全的路径是修正供给侧的问题(恢复驱动、补充配额、创建匹配的 PV),让已有 PVC 正常绑定,而不是删除重建存储对象。
处理动作的优先级与恢复验证
把三个方向串起来,面对一个 Pending 的 Pod,推荐的收敛顺序是:先用 kubectl get 确认影响范围,再用 kubectl describe pod 读调度事件定方向,然后按事件文字进入调度、资源或存储中的一条路径深入核查。整个过程以“读事件、查状态、对照配置”为主,变更放在确认根因之后。
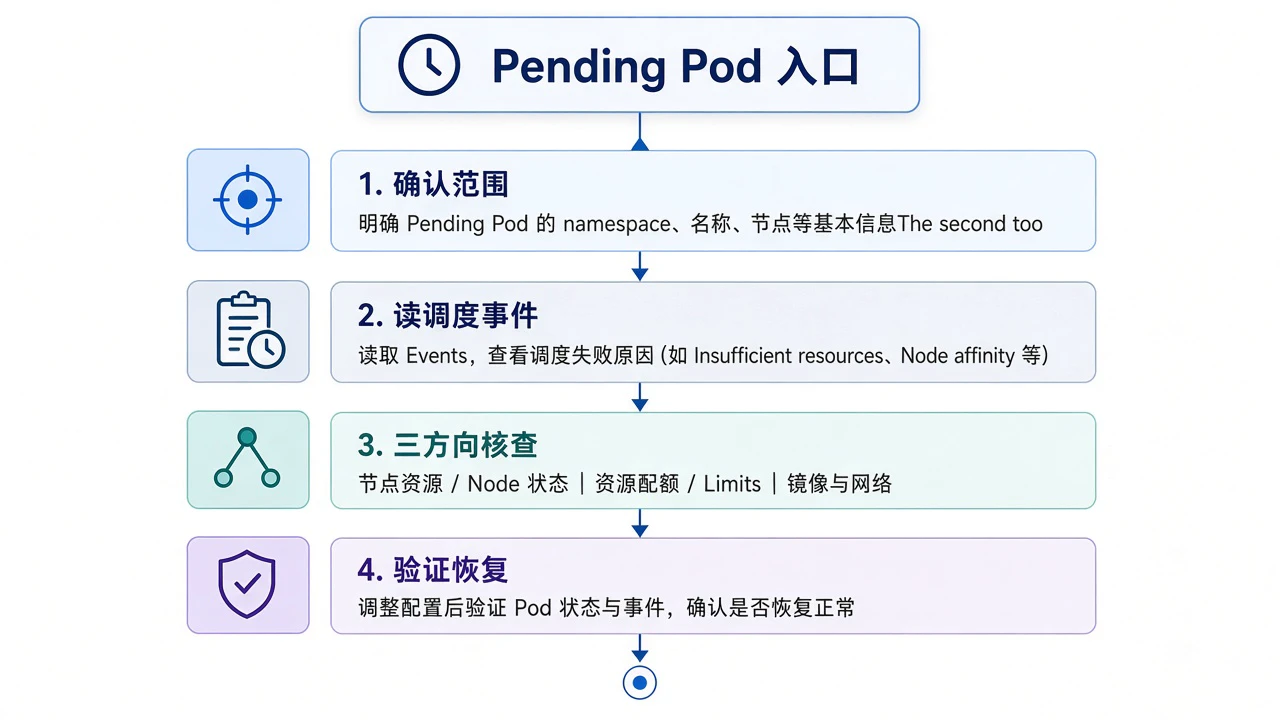
无论从哪个方向处理,验证恢复都遵循同样的逻辑。调整后先观察 Pod 状态是否离开 Pending:
kubectl get pod <pod-name> -n <namespace> -wPod 进入 ContainerCreating 再到 Running,说明调度已经成功,但排查还没结束。要回到事件里确认之前报的理由已经消失,而不是被新的问题覆盖;对资源方向,还要在运行一段时间后观察节点资源水位和 Pod 实际用量,确认校准后的请求值既能让 Pod 落位、又不会在运行期触发压力。
每一次变更都应记录改了什么、改前的配置是什么、以及回滚方式。调度约束和资源请求的回滚通过重新 apply 备份的 manifest 完成,影响面可控;存储对象的变更回滚代价高、风险大,应尽量避免破坏性操作。保持“先定位、后变更、再验证”的节奏,才能让 Pending 问题的处理既快又稳,而不是靠反复删除 Pod 或盲目扩容来碰运气。
发布者:jacky,转转请注明出处:https://kubiyun.com/archives/4627

评论列表(1条)
删了好多次Pod都没解决,原来要先读调度事件才对路子。