主权云过去更多出现在合规文件和厂商宣传中,但近一年它正在成为云平台选型与日常运行设计里必须处理的工程变量。对运维工程师、平台工程师和基础设施负责人来说,关键不是抽象地判断“主权云是否重要”,而是它如何改变部署位置、管理权限、故障恢复和供应商依赖,并如何把这四类影响转化为可验证的架构参数和运行流程。这里的难点在于,主权云往往混合了法规要求、云厂商能力与企业自定策略三层含义,不加区分就容易把合规问题误判成技术问题,或者把厂商限制当成法规限制。
控制权边界:从“数据放在哪里”扩展到“谁能操作系统”
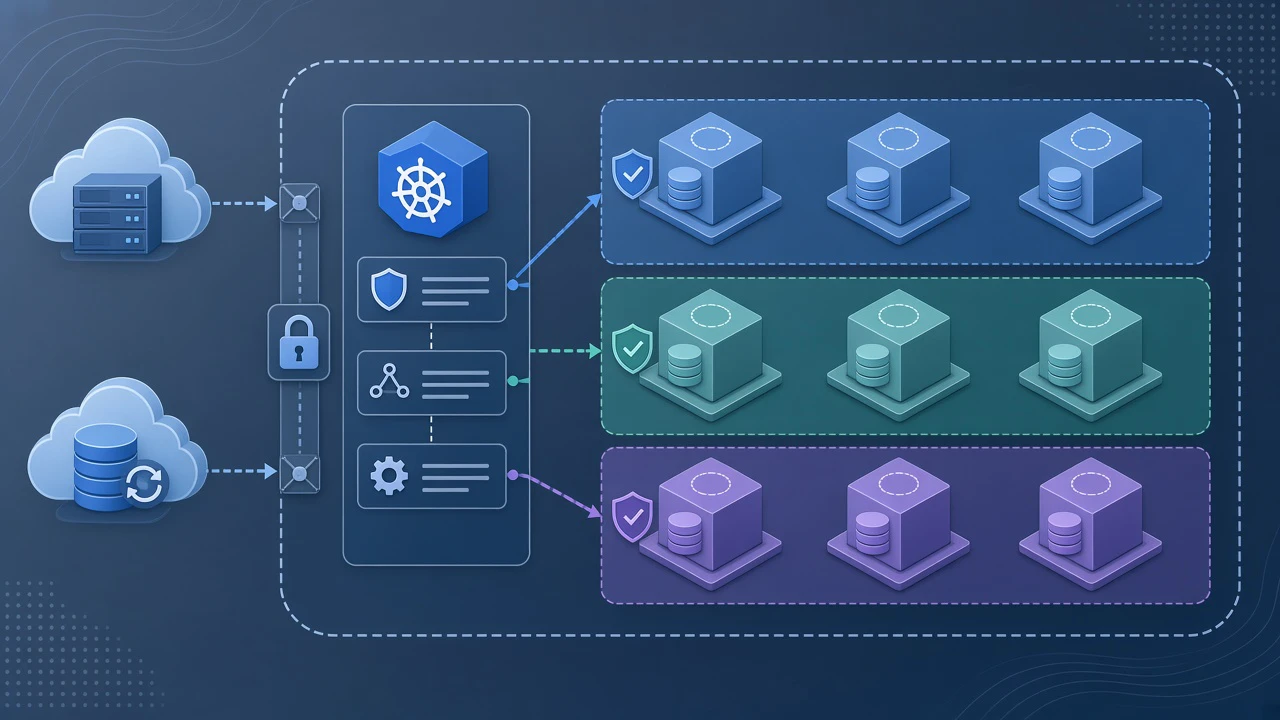
运维团队习惯把主权云等同于数据驻留,即数据不能离开特定国家或司法辖区。但真正影响日常运行的是控制面边界:谁有权触发变更、读取监控日志、执行恢复、升级基础设施、轮换密钥,以及这些操作是否会被外部人员或外部系统经网络跨境完成。数据可以放在本地,但如果控制面 API、监控系统、身份源、工单系统仍然托管在境外公有云,运行可控性并没有真正闭合。
资料中可以看到厂商已经在把控制面边界下沉到具体故障域配置。例如 VMware Cloud Foundation 与 NetApp ONTAP 的设计文档显示,VM 放置规则可以把管理域组件约束在相同故障域内;单一区域内多站点 VCF 机队通过 SnapMirror 主动同步维持两个故障域间的存储关系。这意味着控制面与数据面是否同域、是否允许跨站点管理,已经变成可配置项,而不是笼统的“主权云能力”。对企业而言,法规可能只规定数据驻留,但控制面是否必须由本地团队或本地伙伴运营,往往是企业自定策略或供应商能力问题。
评估控制权时,需要把问题拆开:数据、备份、日志、监控指标、配置库、密钥材料分别存放在哪里;控制面操作是否需要跨境网络;厂商支持人员能否在未经企业审计的情况下访问管理平面。如果控制面必须留在本地,那么故障排查、灰度发布、巡检自动化和审计日志留存都要重新设计。
故障域与灾备设计:区域限制如何改变恢复路径
主权云对故障域的影响不是“少几个区域”这么简单,而是会改变故障转移、备份复制和灾难恢复的可行路径。普通公有云架构通常允许跨区域异步复制、跨区域对象存储备份,甚至在多个地理区域之间做自动故障转移。一旦叠加数据驻留要求,很多跨区域路径会被排除,灾备设计只能收缩到同一司法辖区内的多个可用区、多个数据中心或多个站点。
NetApp 与 VMware 的多站点设计提供了一个可观察的样本:单一区域内多站点可以组成 VCF 机队,利用 SnapMirror 主动同步在两个故障域的存储系统之间保持复制关系,还可通过 SnapMirror 与 SnapMirror to Cloud 实现 3-2-1 备份策略,从三个位置中的任一个执行恢复。跨区域多站点 VCF 车队则面向全球客户提供就近服务和灾难恢复。这里的关键不是某一厂商支持什么功能,而是故障域设计必须从“云区域”进一步细化到“站点”“存储复制关系”“备份副本位置”三个层次。
主权约束下,运维团队需要重新验证:可用区之间的网络是否被允许承载业务数据;备份副本能否放到同一司法辖区的另一个城市;灾备演练是否因为支持人员地理范围而受限;恢复时是否必须先经过本地控制面审批。过去依赖云厂商自动跨区故障转移的假设,可能在主权云方案中不再成立,需要把恢复流程改写为显式的、可审计的步骤。
成本与运维复杂度:合规不是一次性支出
主权云带来的成本不能只看资源单价。受限区域的计算、存储和网络服务往往可选范围更窄,部分托管服务不可用,企业需要自建更多控制面或灾备能力。腾讯云开发者社区关于云部署模式的资料指出,公有云、私有云与混合云的选择本质上是控制权、成本与弹性之间的权衡,数据主权要求严格的企业需要谨慎评估公有云。CSDN 上讨论高成长公司云平台选型的内容进一步给出自建私有云同时满足三个条件:服务器规模超过几百台、有合规或数据主权要求、有足够平台工程团队并且能接受把 20% 以上技术资源投入基础设施。达不到这些条件,自建反而会把团队拖入高固定成本和高运维负担。
主权云的隐性成本还包括:审计证据必须覆盖更多控制面操作,演练需要更频繁地证明数据未被复制到不允许的位置,变更窗口可能因为本地审批链而变长,人员技能需要覆盖混合架构和存储复制关系。知乎上关于混合云管理的讨论提到“云汇回”是成本与主权压力下的再平衡,即把高固定成本或强监管负载迁回私有环境,同时保留公有云的弹性用途。这说明企业实际做法往往不是全量迁入主权云,而是在负载级别重新分配。
评估成本时应区分三类支出:资源价格差、自建与自管成本、合规持续验证成本。资源价格差可以从账单直接看到,后两类则需要计入监控、备份恢复、审计、演练和人员培训的工时。如果只比较虚拟机单价,会严重低估主权云对运维团队的实际占用。
评估问题清单
把主权云从口号转成选型参数时,建议从部署位置、管理权限、故障恢复和供应商依赖四个维度逐项确认。
- 部署位置:数据、备份、日志、监控数据、配置库、密钥分别需要驻留在哪里?哪些区域、站点或可用区组合能够同时满足法规和灾备要求?
- 管理权限:控制面是否本地可达?哪些运维操作需要供应商支持人员跨境访问?所有管理操作是否可审计、可阻断、可追溯?
- 故障恢复:同一司法辖区内的多站点复制是否被允许?灾备站点是否在合规范围内?故障转移流程是否经过主权合规验证,而不只是技术验证?
- 供应商依赖:主权云方案的控制面是否开放?数据导出、备份恢复格式能否被第三方工具读取?退出时能否在不破坏合规前提下取回数据?
- 成本与人力:受限区域资源价格差是多少?需要自建哪些控制面或灾备能力?合规审计、演练和技能缺口会增加多少持续投入?
主权云不是单独的“合规云”品类,而是一组叠加在既有云架构上的约束条件。运维团队的价值不在于复述政策口号,而在于把法规要求、厂商能力和企业自定策略拆开,逐项验证部署位置、管理权限、故障恢复路径和供应商依赖,最终把这些约束转化为可测试、可审计、可恢复的运行设计。这样,主权云才不会变成一张无法落地的合规标签,而是成为基础设施选型中能够被正常评估的工程变量。
发布者:jacky,转转请注明出处:https://kubiyun.com/archives/4614

评论列表(8条)
控制面这个点很多人会忽略
@海澜:控制面确实容易被忽视,关注它能提升运维安全。
跨区复制被限制后,原来的灾备方案基本得推翻重来
@星辰逐风:确实,最头疼的就是那些依赖公有云自动跨区容灾的方案,现在得一个个手动重新拆解链路。
成本这块容易被低估,自建控制面和合规审计的隐性开销才是大头
最后那个评估清单挺实用的,正好可以拿来对一遍方案
@霜满天:希望能帮上忙!对方案时也别漏了控制面权限和备份恢复路径。
退出时数据能不能顺利带走,也得提前想好