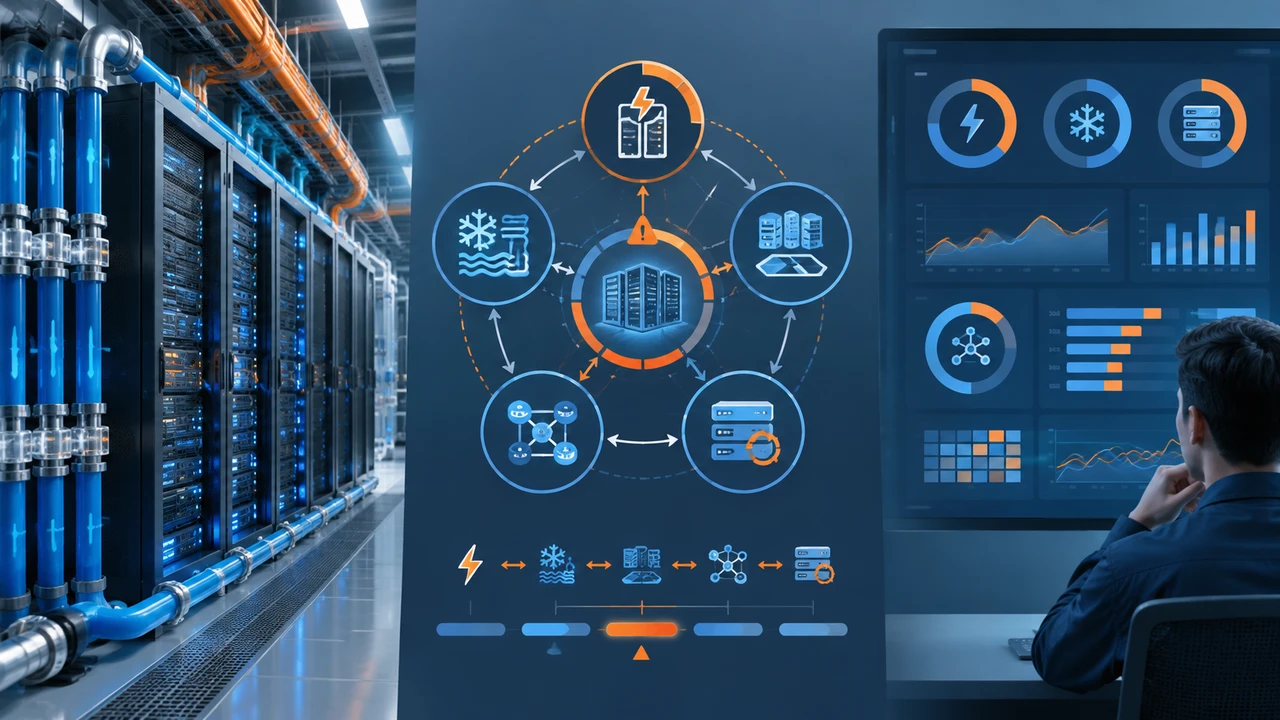
AI算力扩张正在把电力、散热和机房空间从后台保障条件推到容量规划的前台。对运维团队来说,2026年的重点不是简单增加服务器或预留更多机柜,而是把“可用算力”重新定义为同时满足供电、制冷、网络、合规和故障冗余要求的容量,并据此调整监控、调度和预算。
先区分趋势、预测与企业现状
AI服务器部署增加,带来数据中心电力需求和机柜功率密度上升的压力。TrendForce估算,2026年全球数据中心电力需求容量将达到161GW,较上一年增长约31%,并指出AI服务器是主要增长来源。这是行业预测,不等于每个地区、园区或企业都会以同样速度扩容。至顶网报道的数据称,数据中心平均机架功率从2024年的12kW升至2026年的26kW;由于不同统计口径、样本和机房类型可能存在差异,企业不宜直接把行业均值当作本地设计值。
政策方向也在推动设施能力变化。对《促进数字化绿色化协同转型发展实施方案(2026—2030年)》的报道提到,方案涉及液冷、余热回收、探索800V高压直流供电、超百千瓦单机柜部署,以及绿电、储能和算电协同调度。这里反映的是技术探索与政策导向,并不意味着所有机房都必须立即采用同一架构。具体义务仍需结合项目所在地、设施类型和适用法规核对。
因此,容量评估应把信息分成三类:
- 已确认的企业数据:机柜实测功耗、UPS和配电负载、制冷能力、设备告警、云账单及业务负载曲线。
- 行业预测或方向:全球需求增速、机柜密度趋势、政策鼓励方向,用于情景分析,不直接替代设计参数。
- 待核验的本地条件:可获得的电力容量、供电接入时间、冷却改造能力、租赁空间、合规要求,以及扩容成本和周期。
容量规划要从“机柜数”转向多重约束
机柜数和服务器数量仍有用,但不能单独代表可部署容量。规划时至少要同时看以下指标。
| 维度 | 建议跟踪的指标 | 运维上的用途 |
|---|---|---|
| 机柜与电力 | 机柜持续功率、峰值功率、每路PDU负载、进线及母线余量、UPS负载与冗余状态 | 判断新增设备是否能安全上架,以及单点故障后是否仍有供电余量 |
| 散热 | 机柜热负荷、冷却能力余量、进出风或液冷回路温度、流量与压差、热告警频率 | 识别供电尚有余量但制冷已成为瓶颈的区域 |
| 空间与布线 | 可用机柜位、机柜承重、配线空间、线缆路径与维护通道 | 避免把“有空位”误判为“可部署容量” |
| 业务负载 | GPU、CPU、内存和存储利用率,负载峰谷,作业排队时间,服务SLO | 区分算力不足与调度、软件效率或数据供给问题 |
| 故障与恢复 | 单机柜、配电支路、冷却回路和网络域的影响范围,故障切换能力,恢复时间 | 验证冗余是否覆盖真实故障域,而非只满足设备层面的冗余标记 |
尤其要把持续负载和短时峰值分开看。AI作业可能在不同阶段形成不同的功率曲线;只看月平均值,可能掩盖短时过载或冷却响应不足。容量模型宜保留分钟级或更细粒度的关键遥测,并按业务、机柜、供电支路和冷却回路聚合,比较峰值、持续时间和发生频率。
对新建或改造中的高密度区域,还要验证电力和散热是否同时成立。提高供电电压可以改变配电环节的电流与损耗条件,但不能消除设备产生的热量;液冷也不能替代备用供电、回路隔离和维修空间。任何技术路线都需要在整条工程链路中校核,而非只看单项设备参数。
告警阈值应关联容量余量与故障影响
统一的“负载达到某个百分比就告警”往往不够。相同的负载比例,在有双路供电、不同冗余策略或不同冷却条件的区域,风险并不相同。运维团队可按故障域和设备约束设计分层告警:
- 观察级:容量余量连续下降,或负载高于规划基线;用于触发趋势分析和扩容评审。
- 预警级:接近经验证的持续运行上限,或备用路径无法承接单路故障后的负载;用于限制新增部署并检查冗余状态。
- 处置级:出现越限、冷却能力不足、保护装置异常,或关键业务的可靠性目标受到威胁;按预案执行降载、迁移或故障处置。
阈值应来自设备规格、现场测试、冗余设计和历史运行数据,并明确测点、统计窗口、持续时间与责任人。除功率外,建议关联温度、冷却回路状态、UPS电池与旁路状态、PDU告警和网络拥塞情况。告警的目标不是让每项指标都“变绿”,而是在容量余量耗尽前给团队足够的决策时间。
混合云调度需要同时计算成本与可运行性
混合云可以分担本地机房的容量压力,但不能简单理解为把高功耗作业搬到云上。作业是否适合外移,还取决于GPU可用性、数据位置与传输时间、网络带宽、云资源可持续供应情况,以及预算和合规边界。
建议平台团队把调度策略与成本、性能和数据约束放在同一套规则里:
- 将可延迟的训练、批处理与有严格时延要求的在线推理区分开,分别设定调度窗口和服务目标。
- 对数据传输、存储、网络出口及资源预留费用单独核算,避免只比较计算实例单价。
- 为数据驻留、访问控制、审计和跨境传输设置不可绕过的策略;是否允许上云,应由数据和法规要求决定,而不是由空闲容量决定。
- 记录作业迁移前后的完成时间、失败率、资源利用率和总成本,定期复核策略,防止“已迁移”被误当作“已优化”。
混合云能提供调度弹性,但其收益取决于数据路径、资源供给和计费方式。没有经过工作负载测试的成本假设,不能作为固定节省额写入预算。
成本预算应覆盖从电力到维护的完整链路
电力和空间紧张会增加容量获取、改造和运行成本压力,但成本变化幅度取决于地区、电力合同、设施方案和利用率,不能用单一行业数字推算企业账单。预算应按容量单元拆分,至少区分电力、制冷、机柜与空间、网络与存储、设备维护、云资源和扩容改造。
对每一类支出,建议结合业务容量而非只看总额:
- 每单位有效计算任务或业务请求的综合成本;
- 已部署功率与实际利用率之间的差距;
- 空间、电力和制冷余量的可用期限;
- 迁移或扩容带来的网络、存储和运维工作量;
- 为满足冗余、恢复和合规要求而保留的容量。
这些指标有助于识别“买了容量却未有效使用”和“利用率很高但可靠性余量不足”两种不同问题。前者需要检查作业调度、资源配额和闲置策略;后者则需要停止盲目提高利用率,先验证故障切换和峰值承载能力。
把容量治理变成跨团队职责
高密度部署不是运维单方面的上架决策。基础设施团队负责电力、制冷、空间和设备边界;平台团队负责资源编排、配额、作业优先级和跨云调度;网络与存储团队负责数据路径和吞吐;安全、法务及合规团队确认数据处理约束;财务和采购团队则需提供预算、合同和扩容周期信息。
可以建立一份按园区、机房、供电支路、冷却回路和云环境分层的容量台账,规定数据来源、更新频率和责任人,并定期进行容量评审。评审不仅回答“还能部署多少”,还应回答:故障后还能承载多少、哪些业务可以迁移、扩容需要哪些前置条件,以及现有预测与现场遥测之间有多大差距。
对2026年的运维容量规划,更稳妥的做法不是追逐行业平均机柜功率,而是用本地实测建立基线,再围绕需求增长、供电延迟、冷却改造和合规限制做情景分析。行业趋势说明约束正在变得更复杂;最终可用容量、成本和建设节奏,仍必须由企业自身的数据与工程条件验证。
发布者:jacky,转转请注明出处:https://kubiyun.com/archives/4620

评论列表(1条)
拿行业平均值当自己设计值确实容易翻车,还是得拿本地实测数据说话。