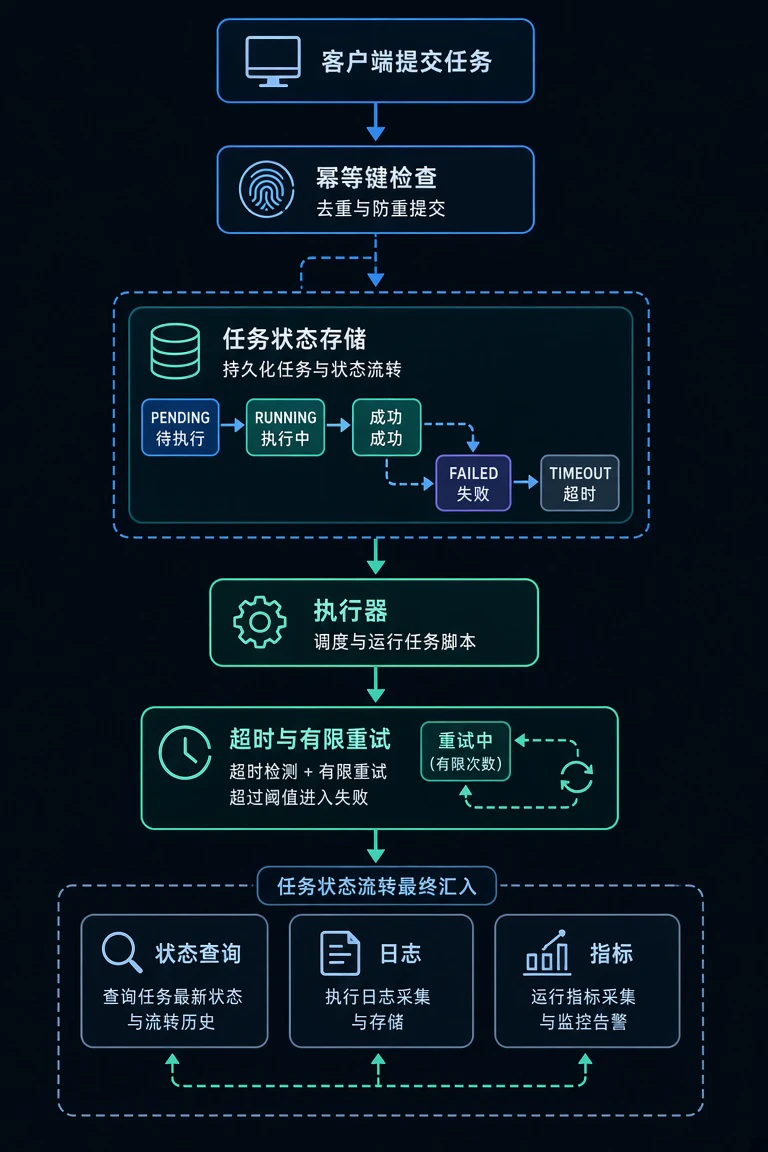
把清理、备份或部署脚本直接挂到 HTTP 接口上,通常只能证明“脚本能执行”,不能证明“任务可治理”。请求超时后客户端可能重复提交,进程被终止后任务状态可能永远停留在运行中,失败重试又可能重复删除或重复发布;如果日志只写在执行进程的标准输出里,事后也很难回答任务执行了几次、失败在哪一步、是否已经产生部分结果。运维自动化要从脚本调用升级为任务服务,核心不是增加一个接口,而是建立任务身份、状态、执行边界和失败证据。
先定义任务服务要解决的问题
一次可治理的任务至少需要区分四类信息:
- 任务身份:这次请求代表哪个业务动作,是否与之前提交过的任务相同。
- 执行状态:任务尚未执行、正在执行、成功、失败、超时,还是已取消。
- 执行尝试:同一个任务可能经历多次尝试,每次尝试都要有独立的开始时间、结束时间和退出原因。
- 结果证据:执行参数、脚本版本、输出摘要、错误类型和最终结果必须能够被查询。
不要把“HTTP 请求是否返回 200”当作任务结果。同步接口返回成功,只能表示任务已经被接受或脚本在当前请求内完成;异步任务则应返回任务标识,由查询接口提供最终状态。
任务状态不能只用成功和失败
建议将任务状态设计为有限状态集合,并明确哪些状态可以转换:
PENDING   -> RUNNING
PENDING   -> CANCELED

RUNNING   -> SUCCEEDED
RUNNING   -> FAILED
RUNNING   -> TIMED_OUT
RUNNING   -> INTERRUPTED

FAILED    -> PENDING      # 允许重新调度时
TIMED_OUT -> PENDING      # 允许重试时
状态转换应由服务端完成,而不是由调用方任意指定。例如,调用方不能直接把 RUNNING 改成 SUCCEEDED。每次转换至少记录:
task_id
from_status
to_status
attempt
changed_at
reason如果服务重启,RUNNING 任务还需要恢复策略。最简单的方式是为运行状态保存心跳时间:启动时扫描超过租约时间没有心跳的任务,将其标记为 INTERRUPTED,然后根据任务策略决定是否重新执行。不能无条件把所有中断任务标记为成功,也不能无条件自动重试可能已经产生副作用的任务。
用幂等键阻止重复副作用
幂等设计解决的不是“接口重复返回相同内容”,而是“同一个业务动作重复到达时,不重复产生副作用”。
例如,备份任务可以使用:
backup:{database_id}:{backup_date}部署任务可以使用:
deploy:{environment}:{release_version}清理任务则可以结合目标范围和策略版本:
cleanup:{cluster}:{retention_policy_version}:{execution_date}幂等键必须由业务语义决定,不能只使用随机请求 ID。随机 ID 能识别一次请求,却无法识别客户端因为超时而再次提交的同一动作。
数据库中应对幂等键建立唯一约束:
CREATE TABLE tasks (
    id              TEXT PRIMARY KEY,
    idempotency_key TEXT NOT NULL UNIQUE,
    task_type       TEXT NOT NULL,
    payload         TEXT NOT NULL,
    status          TEXT NOT NULL,
    attempt         INTEGER NOT NULL DEFAULT 0,
    max_attempts    INTEGER NOT NULL DEFAULT 3,
    next_run_at     TIMESTAMP,
    created_at      TIMESTAMP NOT NULL,
    updated_at      TIMESTAMP NOT NULL,
    finished_at     TIMESTAMP,
    error_code      TEXT,
    error_message   TEXT
);
提交逻辑要处理竞态:两个请求几乎同时使用同一个幂等键时,只有一个请求创建任务,另一个请求读取已经存在的任务。依赖“先查询、再插入”而没有唯一约束是不够的,因为两个请求可能同时通过查询。
提交接口可以遵循以下语义:
- 幂等键不存在:创建任务并返回
201。 - 幂等键已存在且参数一致:返回原任务标识及当前状态。
- 幂等键已存在但参数不同:返回冲突,不允许复用该键。
- 原任务已经成功:直接返回原结果,不重新执行。
- 原任务失败:是否允许重新执行由任务策略决定,而不是由调用方隐式触发。
幂等键还应设置作用域。例如同一个键是否只在单个租户、集群或环境内唯一,必须在数据模型中明确,否则不同环境可能被误判为同一个任务。
把超时分成多个边界
“超时”至少有三种含义:
- 请求超时:调用方等待 HTTP 响应的时间。
- 排队超时:任务从创建到获得执行资源的最长等待时间。
- 执行超时:脚本进程从启动到结束的最长运行时间。
请求超时不等于任务停止。对于异步任务,客户端可以在请求超时后重新查询任务;对于同步任务,服务端也必须避免请求连接断开后留下无法管理的进程。
执行超时时,不能只停止父进程。脚本可能启动子进程、管道或后台命令,单独终止父进程会留下孤儿进程,造成重复执行或资源泄漏。实际执行器应创建独立进程组,并在超时后按顺序处理:
- 停止接受该任务的新输出;
- 向进程组发送可捕获的终止信号;
- 等待一个有限宽限期;
- 仍未退出时强制终止整个进程组;
- 记录
TIMED_OUT,包括超时时长和终止结果。
超时后是否重试要谨慎。部署脚本已经完成一半时,自动重试可能再次执行迁移或覆盖配置;只有在脚本具备幂等性,或者能够通过检查点确认未完成副作用时,才适合自动重试。
有限重试必须区分错误类型
失败重试不是“失败就再跑一次”。建议至少区分以下错误:
| 错误类型 | 示例 | 默认处理 |
|---|---|---|
| 参数错误 | 目标环境不存在、参数格式错误 | 不重试 |
| 权限错误 | 凭据过期、权限不足 | 不自动重试,告警 |
| 资源暂时不可用 | 数据库连接池耗尽、临时网络错误 | 有限重试 |
| 执行超时 | 脚本超过执行时限 | 仅对可安全重试的任务重试 |
| 进程中断 | 主机重启、执行器崩溃 | 先恢复状态,再按策略决定 |
| 部分成功 | 已创建资源但后续步骤失败 | 通常进入人工处理或补偿流程 |
重试次数应记录在任务实体中,不能只存在执行器内存里。一个常用的退避计算方式是:
import random

def retry_delay(attempt: int, base: float = 2.0, cap: float = 300.0) -> float:
    # attempt 从 1 开始,加入少量抖动,避免大量任务同时重试
    exponential = min(cap, base * (2 ** (attempt - 1)))
    return exponential * (0.8 + random.random() * 0.4)
生产实现还需要设置总重试时间上限。即使每次间隔有限,任务也不应在失败数小时后仍悄悄重试。达到 max_attempts 后,任务应进入最终失败状态,并触发可查询、可告警的失败记录。
执行器要同时限制并发和资源
全局并发限制只能解决一部分问题。不同任务通常需要不同的资源配额:
- 清理任务限制目标主机或集群并发数;
- 备份任务限制磁盘带宽和数据库连接数;
- 部署任务限制同一环境只能有一个活动版本;
- 高成本任务限制每个租户或项目的并发数。
因此可以同时使用全局信号量和业务资源锁。资源锁的持有时间应覆盖整个任务生命周期,包括重试之间的等待阶段是否释放,也要明确设计。若任务只要求同一环境不能同时执行,可以在单次尝试结束后释放锁;若重试期间必须保持顺序,则应把任务置于可恢复队列,而不是让多个尝试竞争同一目标。
最小执行模型
下面的示例展示一个进程内执行器的核心边界。它没有包含完整的数据库和队列实现,但体现了任务状态、超时、有限重试和并发控制之间的关系:
import asyncio
from dataclasses import dataclass
from enum import Enum


class Status(str, Enum):
    PENDING = "PENDING"
    RUNNING = "RUNNING"
    SUCCEEDED = "SUCCEEDED"
    FAILED = "FAILED"
    TIMED_OUT = "TIMED_OUT"


@dataclass
class Task:
    task_id: str
    command: list[str]
    timeout_seconds: int = 600
    max_attempts: int = 3
    attempt: int = 0
    status: Status = Status.PENDING


class TaskRunner:
    def __init__(self, concurrency: int = 4):
        self.semaphore = asyncio.Semaphore(concurrency)

    async def run_once(self, task: Task) -> tuple[Status, str]:
        process = await asyncio.create_subprocess_exec(
            *task.command,
            stdout=asyncio.subprocess.PIPE,
            stderr=asyncio.subprocess.PIPE,
            start_new_session=True,  # 生产环境还应管理整个进程组
        )

        try:
            stdout, stderr = await asyncio.wait_for(
                process.communicate(),
                timeout=task.timeout_seconds,
            )
        except asyncio.TimeoutError:
            process.kill()
            await process.wait()
            return Status.TIMED_OUT, "execution timeout"

        output = stdout.decode(errors="replace")[-4000:]
        error = stderr.decode(errors="replace")[-4000:]

        if process.returncode == 0:
            return Status.SUCCEEDED, output

        return Status.FAILED, (
            f"exit_code={process.returncode}; stderr={error}"
        )

    async def run(self, task: Task) -> Task:
        async with self.semaphore:
            while task.attempt < task.max_attempts:
                task.attempt += 1
                task.status = Status.RUNNING
                # 这里必须先持久化 RUNNING 和 attempt

                status, detail = await self.run_once(task)

                if status == Status.SUCCEEDED:
                    task.status = Status.SUCCEEDED
                    # 持久化成功结果、结束时间和输出摘要
                    return task

                task.status = status
                # 持久化本次尝试的错误和结束时间

                if not self.is_retryable(task, status, detail):
                    break

                await asyncio.sleep(min(2 ** task.attempt, 60))

            task.status = Status.FAILED
            # 持久化最终失败状态
            return task

    def is_retryable(
        self, task: Task, status: Status, detail: str
    ) -> bool:
        if task.attempt >= task.max_attempts:
            return False
        if status == Status.TIMED_OUT:
            return False  # 默认关闭,按任务类型显式开启
        if "exit_code=2" in detail:
            return False  # 示例:把参数错误视为不可重试
        return True
这个示例有几个必须补强的地方:
process.kill()只代表示例行为,生产环境应终止整个进程组。- 状态更新必须落到持久化存储,不能只修改内存对象。
stdout和stderr应限制大小或流式写入日志系统,避免大输出占满内存。command不能由不可信请求直接拼接 shell 字符串,应使用参数数组,并限制可执行文件和参数范围。- 重试判断应由任务类型和错误分类决定,不能通过匹配任意错误文本完成。
- 进程内执行器重启后会丢失调度上下文,因此需要启动恢复、租约或改用持久化队列。
进程内执行与队列异步执行的取舍
两种方案都可以作为任务服务的起点,但适用边界不同:
| 维度 | 进程内执行 | 队列异步执行 |
|---|---|---|
| 实现复杂度 | 低,适合快速改造 | 较高,需要队列、消费者和恢复机制 |
| 响应方式 | 易做同步或短任务 | 天然适合提交后查询 |
| 服务重启影响 | 运行上下文容易丢失 | 可依赖持久化消息和任务记录恢复 |
| 并发控制 | 信号量和本地锁即可 | 可做全局并发、分组消费和限流 |
| 超时处理 | 需要自行管理进程生命周期 | 由消费者执行,但仍需处理孤儿进程 |
| 水平扩展 | 受单实例资源限制 | 更容易扩展消费者 |
| 改造成本 | 适合已有脚本的第一步封装 | 适合长任务、高可靠和多节点执行 |
短时、低并发、失败影响有限的任务可以先使用进程内执行,但必须把任务状态持久化,并避免把进程内队列当作可靠队列。备份、批量清理、跨主机部署等任务更适合队列异步执行,因为它们通常运行时间长、资源消耗高,且需要在服务重启或节点故障后恢复。
队列也不会自动解决幂等问题。消息可能重复投递,消费者也可能在任务已经产生副作用后崩溃。因此消费者仍需根据任务幂等键和持久化状态执行去重,并让脚本本身支持安全重入。
失败可观测性要记录“为什么失败”
日志、指标和任务查询接口承担不同职责,不能相互替代。
任务查询接口
至少提供:
GET /tasks/{task_id}返回:
{
  "task_id": "t-123",
  "status": "FAILED",
  "attempt": 3,
  "max_attempts": 3,
  "created_at": "2025-01-01T10:00:00Z",
  "started_at": "2025-01-01T10:00:02Z",
  "finished_at": "2025-01-01T10:08:20Z",
  "error_code": "REMOTE_TIMEOUT",
  "retryable": false,
  "result_summary": "backup target remained unavailable"
}
错误信息应包含稳定的 error_code,便于程序和告警规则使用;error_message 可以面向工程师,但不应把凭据、访问令牌或完整敏感参数写入响应。
日志字段
每次尝试都应携带结构化字段:
task_id
idempotency_key
task_type
attempt
status
target
executor_id
started_at
finished_at
duration_ms
error_code
exit_code
任务日志和脚本原始输出可以分开保存。原始输出适合排障,结构化事件适合检索和统计。对标准输出设置大小上限,并对密码、连接串、令牌和密钥进行脱敏。
指标维度
建议关注这些指标:
- 任务提交总数和按类型的提交量;
- 成功率、最终失败率、超时率;
- 每次尝试耗时和端到端耗时;
- 重试次数分布;
- 当前
PENDING、RUNNING数量; - 队列等待时间;
- 并发限制触发次数;
- 幂等键重复提交次数;
- 被中断后恢复的任务数量。
指标标签不要直接使用任务 ID、完整幂等键或目标资源名称,否则高基数会增加监控系统压力。可以使用任务类型、错误码、环境等有限集合字段。
用故障注入验证任务行为
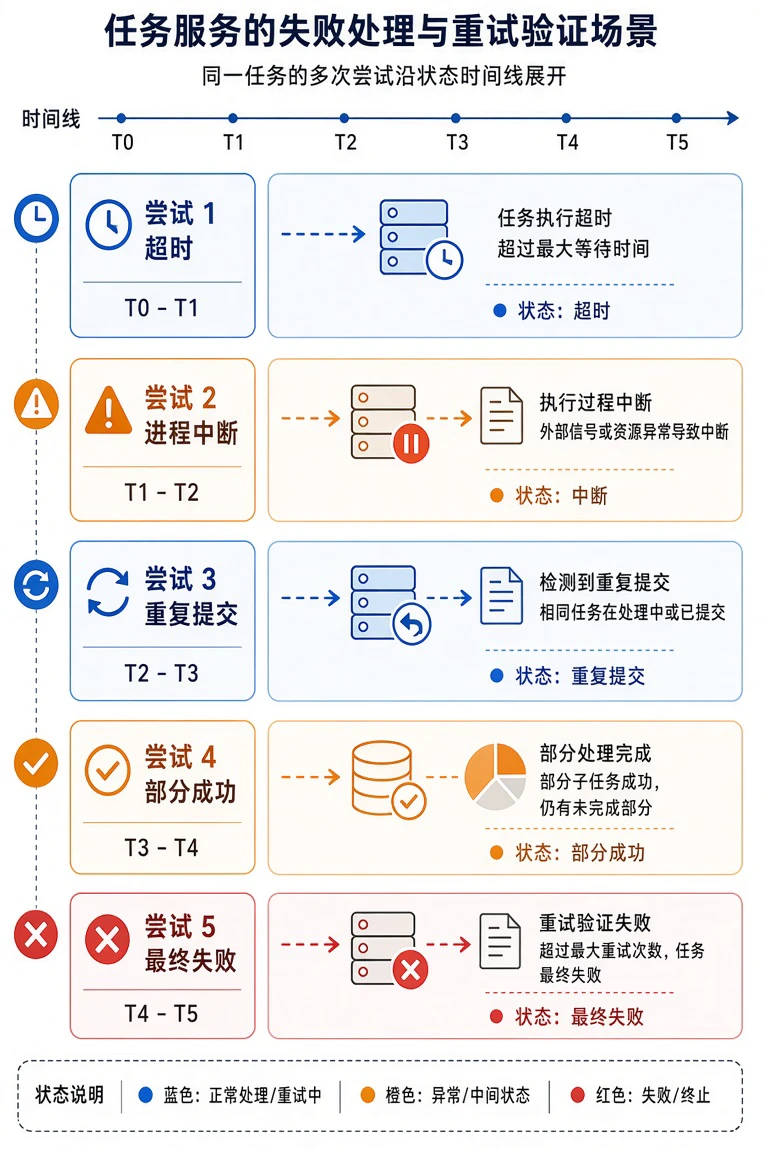
实现完成后,不要只测试脚本成功执行。至少验证以下场景:
- 重复提交
连续提交两次相同幂等键,确认只创建一个任务;参数不同时返回冲突。
- 执行超时
让脚本休眠超过执行时限,确认状态变为 TIMED_OUT,子进程被清理,是否重试符合任务策略。
- 执行器中断
在任务运行过程中停止服务,重启后确认任务不会永久停留在 RUNNING,并根据租约或恢复策略进入可预期状态。
- 有限重试
让脚本前两次失败、第三次成功,确认尝试记录完整,最终任务只报告成功但保留前两次失败证据。
- 最终失败
让脚本每次都失败,确认达到最大尝试次数后停止,不会无限重试,并产生告警所需的错误码。
- 部分成功
让脚本在创建资源后于下一步失败,确认任务结果标记为部分失败或失败,并记录已经完成的步骤;再次执行时不能重复创建资源。
- 并发限制
同时提交超过配额的任务,确认超出的任务进入排队而不是直接丢失,也不会绕过限制启动。
- 输出过大和敏感信息
让脚本生成大量日志并输出测试凭据,确认日志有大小控制且敏感字段被脱敏。
验证的重点不是“脚本最终是否成功”,而是每个异常路径都有确定的状态、有限的资源占用、可解释的重试行为和可查询的失败证据。
一个可落地的最小边界
第一次改造不必立即建设完整平台,但至少应具备以下闭环:
- 用持久化任务表保存任务和尝试记录;
- 用唯一幂等键防止重复创建;
- 用明确状态机约束状态转换;
- 用独立执行器管理进程、超时和并发;
- 用错误分类决定是否重试;
- 用最大尝试次数和总时限阻止无限重试;
- 用结构化日志、错误码和指标支持失败定位;
- 用故障注入验证重复提交、中断、超时和部分成功。
这样封装后的运维自动化,才不只是把脚本换了一个 HTTP 外壳,而是具备了可重复执行、可恢复、可限制和可追踪的任务服务边界。
发布者:jacky,转转请注明出处:https://kubiyun.com/archives/4589

评论列表(7条)
进程组清理这点太关键了,很多脚本超时后子进程还在跑
随机请求ID挡不住重复提交,幂等键得绑定业务动作
@煎蛋糊了:对,随机 ID 只能标识请求,业务幂等键才能识别同一动作,还得配合唯一约束处理并发提交。
失败原因能查到,比单纯报个失败实用多了
@表情包达人:对,失败状态只是结果,能定位到哪次尝试、哪一步,才方便判断是否重试。
服务重启后运行中的任务怎么接回来,这个恢复策略很容易被忽略
日志限长和敏感信息脱敏也不能省,脚本最容易把凭据打出来