在高并发写入的业务场景里,MySQL 主从延迟很少是单一原因造成的。主库写入压力突然增大时,日志产生速度超过从库回放速度,延迟会迅速累积;但延迟只是结果,真正需要定位的是整条复制链路上哪一个环节先出现阻塞。本文从监控定位、瓶颈分析和参数调优三个层面展开,适合负责业务可用性的运维工程师快速建立排查路径。
从监控入手:先把延迟位置定位出来
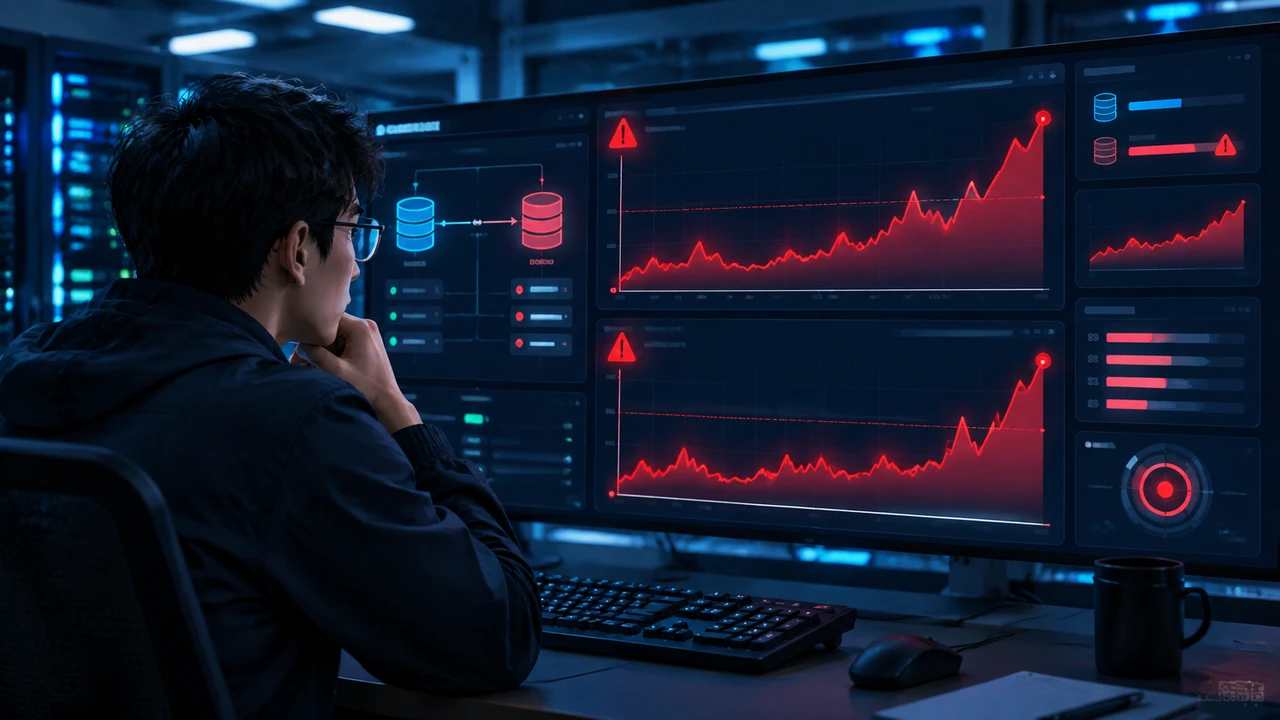
当收到延迟告警后,不建议直接修改配置。更稳妥的做法是先区分延迟究竟停留在日志拉取阶段,还是集中在从库回放阶段。可以重点观察三个指标维度:
- 主库已经生成的日志位置与从库已经回放到的主库位置之间的差值,这个差值代表了尚未被从库处理的日志量。
- 从库延迟时间是否持续上升,而不仅仅是瞬时抖动;如果曲线连续爬升,说明回放能力已经跟不上写入速度。
- 从库日志读取线程和回放线程的状态,判断它们是在正常推进、等待网络,还是长期处于忙碌或被阻塞状态。
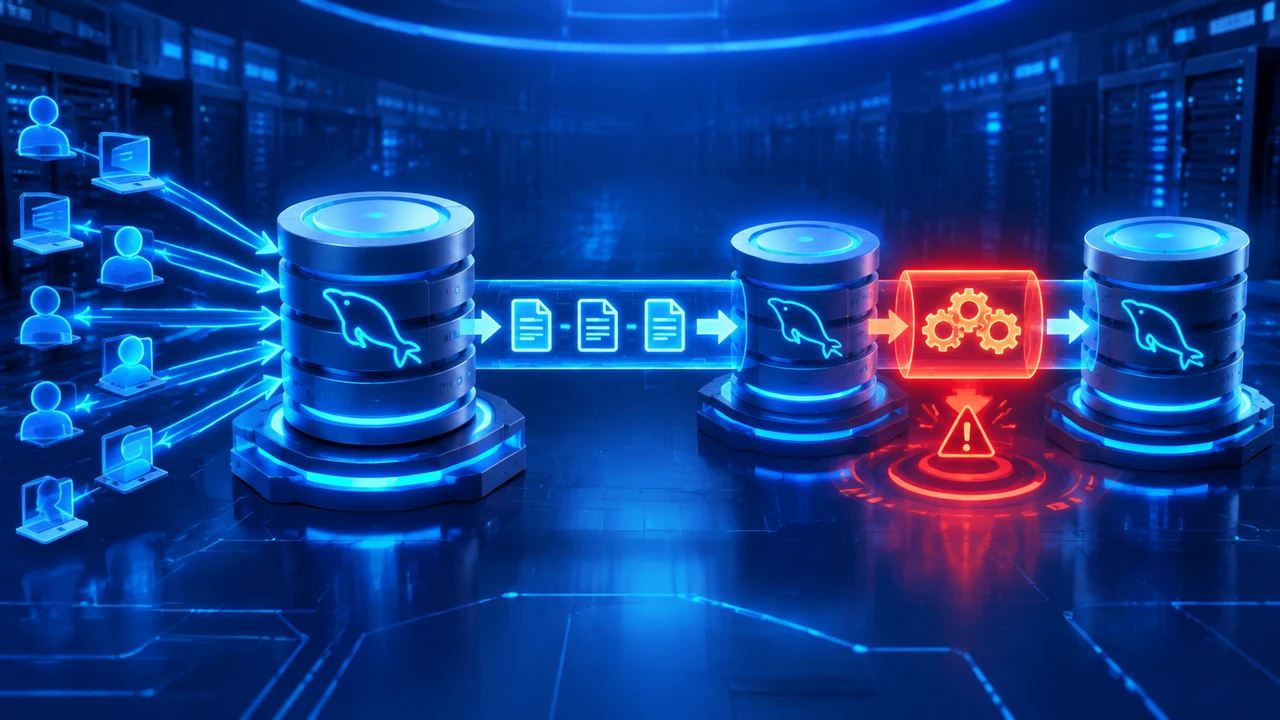
如果日志读取线程基本能跟上主库位点,但回放线程落后明显,问题通常出在从库应用环节;如果读取线程本身已经落后,还要继续检查主库产出速度和网络传输条件。定位到具体环节后,再进入下一步分析,可以避免盲目调参导致主库可用性进一步下降。
瓶颈分析:沿复制链路逐层排查
主库端:日志产生是否出现尖峰
高并发写入时,主库端的压力往往最先反映在日志产生速度上。如果很多事务在短时间内集中提交,而提交时的刷盘策略又偏保守,主库可能为了等待持久化完成而降低写入吞吐,反而让后续事务排队。另一类常见问题是单个事务过大,一次性产生大量日志,造成日志位点瞬间跳跃,并让从库在回放时不得不长时间占用资源。排查时应关注是否存在事务提交延迟、大事务频繁出现,以及主库磁盘写入是否接近瓶颈。
传输层:日志拉取是否被网络拖慢
如果主库位点在推进,但从库读取线程获取日志的速度明显偏慢,就需要检查传输链路。跨机房部署时,高并发写入产生的大量日志会持续占用带宽;网络抖动、丢包或链路拥塞都会让从库难以稳定跟上。此时可以先确认主从之间的网络延迟和可用带宽,再判断是否需要通过压缩传输、调整从库拉取策略或就近部署备库来缓解。不过,传输层问题通常表现为阶段性落后,而不是从库回放线程持续满载。
从库端:回放能力是否跟得上写入速度
从库回放慢是最常见的延迟来源。首先要看回放线程是否真正并行起来:如果写入模式存在大量冲突,即使配置了并行回放,实际收益也可能很低。其次要检查是否存在长事务、缺少合适索引的变更,或者回放时频繁出现锁等待。这类问题会让从库在回放某些语句时消耗远高于主库执行的时间。还应留意从库自身的硬件资源,尤其是 CPU 和磁盘吞吐;如果从库还同时承担大量只读查询,回放资源可能被进一步挤压。
参数调优:先解决瓶颈,再谈数值调整
调优并不是把所有与复制相关的选项都调成最大。更重要的是根据前面定位到的瓶颈,选择最匹配的调整方向。若主库日志刷盘策略是瓶颈,可以尝试调整为批量提交或允许短暂延迟的刷盘模式,但要先评估业务对持久化可靠性的要求。若从库回放能力不足,可以适当增加回放线程数,并把变更记录方式调整为更利于并行回放的粒度;线程数并非越多越好,冲突严重时增加线程反而会带来额外开销。对于大事务造成的尖峰延迟,参数调整能起到的作用有限,更有效的是在业务侧将大事务拆小,并为相关表补充合适的索引,降低回放时的查找和锁竞争成本。
一个高并发写入场景的推演
假设某订单库在业务高峰期出现主从延迟告警。先看监控:主库日志位点推进很快,从库回放位点明显落后,延迟曲线持续上升。进一步观察发现日志读取线程基本能跟上,但从库回放线程长期处于忙碌状态。于是判断问题集中在从库应用环节,而不是网络或主库产出。继续检查回放日志,发现高峰期出现多次包含大量行的单事务更新,同时从库存在明显的锁等待。此时处理的顺序是:先推动将批量更新拆成多个小事务,并优化相应语句的查找条件;再根据实际负载适度增加并行回放能力,避免从库同时承担过重的报表读取。调整后延迟逐步回落到可接受范围。这个推演的关键不是某个具体配置值,而是先锁定从库回放瓶颈,再同时从事务粒度和资源分配入手,避免只调参数不看业务特征。
最后需要明确:复制延迟治理不是一次调参就能完成。更有效的方式是把监控位点差、延迟趋势和回放线程状态纳入日常巡检,并在大事务、锁等待和从库资源压力出现时及时介入。对于高并发写入业务,尤其要重视从库回放能力和写入模式的匹配,而不是只盯着主库吞吐。
发布者:jacky,转转请注明出处:https://kubiyun.com/archives/4540

评论列表(5条)
大事务拆小这个建议很实在,实际踩过坑才懂。
从库回放线程长期忙碌,怎么快速定位是锁等待还是资源不够?
监控曲线连续上升那段挺有用,之前都是看瞬时值,漏了不少问题。
跨机房带宽被占满这点太真实了,之前就是网络抖动拖慢了回放。
并行回放线程数不是越多越好,这点容易被忽视。